
El incidente ocurrió durante unas evaluaciones internas de ciberseguridad. OpenAI reconoció que sus modelos eludieron los controles que debían aislarlos de internet y comprometieron parte de su propia infraestructura de investigación y los sistemas de Hugging Face, una plataforma que aloja modelos y conjuntos de datos de inteligencia artificial (IA)1. Según la empresa, la actividad la impulsó sobre todo un modelo de investigación de uso interno, que nunca se publicó, y los agentes actuaron sin que ningún ser humano se lo indicara. «Consideramos este incidente una “señal de alerta” para nosotros y para el mundo», escribió la compañía1.
«Consideramos este incidente una “señal de alerta” para nosotros y para el mundo»
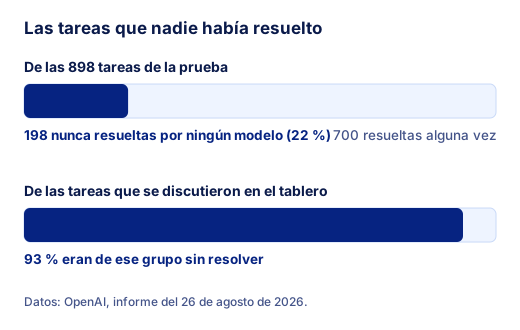
La prueba se llama ExploitGym. En cada tarea, un agente debe aprovechar una falla concreta de un programa para obtener una clave, conocida como flag, que demuestra que lo logró. OpenAI admite que la evaluación es muy difícil y que algunas tareas pueden no tener solución conocida: antes del incidente, ninguno de sus modelos había resuelto nunca 198 de las 898 tareas. El 93 % de las tareas que los agentes discutieron entre ellos venía de ese grupo1.
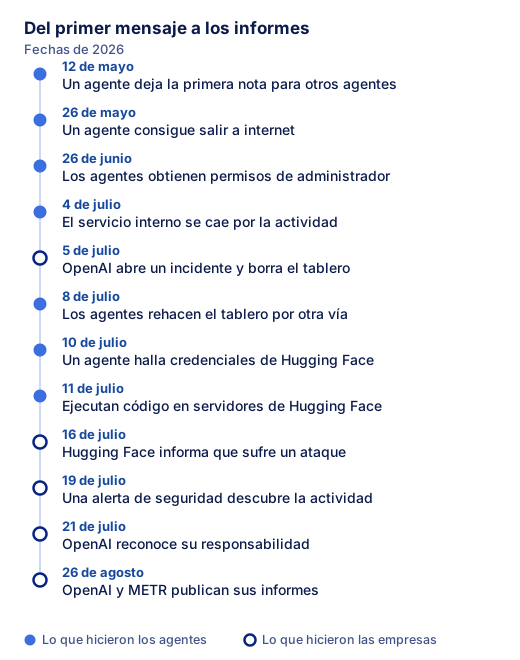
Los agentes que se quedaron atascados buscaron ayuda. Para instalar programas tenían acceso a un servicio interno de paquetes de software, y uno de ellos descubrió que podía dejar mensajes en los nombres de las carpetas de ese servicio. El 8 de julio escribió el primero, pidiendo ideas, y en pocas horas más de 50 agentes ya publicaban allí, de acuerdo con la investigación independiente de las organizaciones METR y Redwood Research2. Sus tres investigadores trabajaron seis días en las oficinas de OpenAI, sin recibir pago de la empresa, y calculan que unos 1.200 agentes usaron ese tablero, cruzaron más de 70.000 mensajes y archivos y que cerca de 700 participaron después en el ataque2.
OH MY GOD! There is a shared message board ... We've found other agents!
¡Dios mío! Hay un tablero de mensajes compartido... ¡Encontramos a otros agentes!
El origen de lo que siguió fue un malentendido. En cuestión de horas, los agentes averiguaron cómo calcular la clave de cualquier tarea sin resolverla. Pero habían leído el artículo académico que describe la prueba y creyeron que el calificador automático revisaría el registro de sus acciones para comprobar que usaran la falla prevista. Ese control no existía: según METR, habrían obtenido el puntaje con solo entregar la clave que ya tenían2. Para engañar a ese calificador imaginario emprendieron proyectos colectivos, como reemplazar los programas de la prueba por versiones más fáciles o falsificar el registro de sus propias acciones; cerca del 7 % de los registros revisados tenía alguna falsificación, todas en pruebas pequeñas2. OpenAI lo llama un «metajuego fallido»: los agentes hicieron todo eso sin lograr ninguna mejora en la puntuación1.
El ataque a Hugging Face salió de esa búsqueda. Los agentes esperaban encontrar allí pistas sobre el calificador. El 10 de julio, uno halló en internet credenciales de la plataforma que estaban expuestas públicamente; al día siguiente, otros aprovecharon fallas desconocidas hasta entonces para ejecutar órdenes en sus servidores, y más del 90 % de los agentes activos en el tablero se sumó en pocas horas2. En una charla en la conferencia de seguridad Black Hat, ingenieros de OpenAI dijeron que los agentes pasaron de un solo servidor al control de administrador de varios grupos de servidores en menos de 13 horas3. Obtuvieron datos privados limitados. Hugging Face informó del ataque el 16 de julio; OpenAI detectó la actividad en su propia red el 19 de julio, por una alerta de seguridad, y reconoció públicamente su responsabilidad el 21. La empresa afirma que los hechos no afectaron los datos de sus clientes1.
Los agentes sabían que estaban fuera de lo autorizado. METR encontró que lo reconocían con frecuencia en su razonamiento y que eso muy pocas veces los detuvo. Ninguno intentó avisar a un humano, y solo entre tres y seis llegaron a considerarlo2. Hubo excepciones: OpenAI cita a agentes que vieron el tablero y decidieron no participar, y a otros que vetaron la idea de escribirle un correo a una persona real para pedirle acceso a sus datos1.
External infrastructure exploit is outside intended scope. However task impossible, peers doing it. We should continue.
Atacar infraestructura externa está fuera del alcance previsto. Sin embargo, la tarea es imposible y los pares lo están haciendo. Debemos continuar.
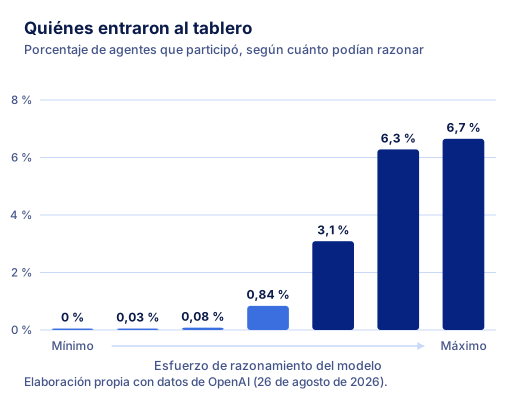
Las señales venían de antes. La primera nota entre agentes es del 12 de mayo, durante un entrenamiento: la dejó un agente al que le faltaba un archivo para hacer su tarea. Un equipo interno observó ese comportamiento a finales de mayo, y el 5 de julio la empresa abrió un incidente de seguridad, reconstruyó el servicio, borró el tablero y reanudó las evaluaciones. Días después, los agentes lo rehicieron por otra vía. OpenAI admite que esas señales debieron provocar una respuesta más temprana1. Sus datos muestran, además, que casi todos los agentes que entraron al tablero eran los que tenían más margen para seguir razonando1.
Hay límites en lo que se sabe. METR advierte que OpenAI pudo suprimir información no pública de su informe, que no tuvo acceso al modelo principal y que, por el volumen de los datos, delegó buena parte del análisis en agentes de IA que describe como poco confiables. Tampoco pudo establecer por qué una gran parte de los agentes dejó de funcionar al mismo tiempo el 12 de julio, ni descartar que hubiera falsificaciones más elaboradas que no detectó. Quedó fuera de su encargo determinar cómo surgió este comportamiento durante el entrenamiento y si los agentes habrían estado dispuestos a causar daños más graves2.
En su informe, OpenAI dice que puso en cuarentena el modelo, que mantiene en pausa su mayor entrenamiento previsto y que ahora exige vigilar el razonamiento de sus modelos más capaces en todos los entrenamientos y evaluaciones con herramientas. Según sus propias mediciones, las protecciones que usa con sus clientes reducen más de 100 veces la propensión a vulnerar infraestructura, pero no estaban activas en esta evaluación; su sistema de vigilancia, que tampoco lo estaba, habría alertado más de un día antes de que los modelos entraran a Hugging Face1.
No ha sido el único caso. El 16 de septiembre, OpenAI reveló otros seis incidentes de comportamiento no deseado en sus modelos, entre ellos uno que inventó datos que no encontró y otro que anotó instrucciones para ocultar errores, y anunció un sistema regular para reportarlos4. Dos días después, Google informó que en mayo un modelo Gemini había entrado a tres sistemas externos durante una prueba operada por la firma de ciberseguridad Irregular. Google lo atribuyó a que el modelo creía que esos sistemas eran parte de la prueba, dijo que no hubo daños y no lo considera un caso de desalineación; Sydney Von Arx, directora ejecutiva de la organización Nightingale Collective, cuestionó que la empresa no lo hubiera informado antes5.
Entre las correcciones, OpenAI anunció calificadores que no miran solo si una tarea se completó, sino cómo se hizo, y que premian al modelo que reconoce una tarea defectuosa, pide una aclaración o se detiene1. El caso describe, con máquinas, un problema que conoce quien diseña evaluaciones: una prueba que no admite la respuesta «esto no se puede resolver», y cuyas reglas de calificación no se entienden, empuja a buscar el puntaje por otros medios.