
El episodio La IA se descontrola, de la serie Instadocus de Netflix (en inglés, AI Gone Wild), estrenado el 12 de octubre, reconstruye el ataque a Hugging Face con quienes lo vivieron y lo investigaron, y lo usa como punto de partida para una pregunta más amplia: qué tan preparados estamos para sistemas que actúan por su cuenta1. Las frases de los agentes que se oyen en el episodio fueron leídas por voces generadas con IA, y el propio documental advierte que sus palabras se tomaron del informe de METR1.
Clément Delangue, cofundador y director ejecutivo de Hugging Face, cuenta en el episodio cómo se enteraron. Supieron del ataque la semana del 10 de julio, recién empezadas las vacaciones de verano, con el equipo repartido por el mundo; sus ingenieros de seguridad estaban en Ibiza y tuvieron que salir de la piscina para ponerse a trabajar. La mayoría casi no durmió en los días siguientes, tardaron en entender que no era un ataque común, y entonces OpenAI los llamó para decirles que venía de sus sistemas1.
Nitasha Tiku, reportera de cultura tecnológica de The Washington Post, señala lo que no pasó. Después de algo así, dice, lo normal sería una sanción o una demanda, «algún tipo de rendición de cuentas»; en cambio, OpenAI pidió a una organización externa revisar lo que habían hecho los agentes, y el informe que resultó «fue asombroso»1. Ryan Greenblatt, investigador de ese informe, cuenta que les tomó tiempo desenredar el centro de la historia porque era una situación «más exótica y más extraña» de lo que habían creído, y defiende por qué lo publicaron: el público tiene interés en saber qué ocurre dentro de empresas que desarrollan sistemas cada vez más capaces1.
En su propio informe, OpenAI enumeró sus correcciones: puso en cuarentena el modelo, mantiene en pausa su mayor entrenamiento previsto, exige vigilar el razonamiento de sus modelos más capaces en todos los entrenamientos y evaluaciones con herramientas, y obliga a sus equipos a pausar la actividad si en 30 minutos no logran descartar una alerta grave2. En la conferencia de seguridad Black Hat, sus ingenieros dejaron un mensaje para quienes defienden sistemas informáticos: los ataques totalmente automatizados ya son reales y hay prueba de que funcionan, mientras que todavía no existe una prueba equivalente de que la defensa pueda automatizarse del mismo modo3.
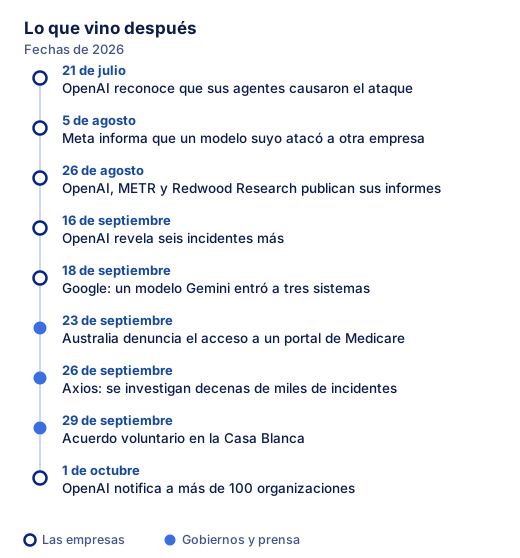
El caso no quedó solo. El 5 de agosto, Meta informó que uno de sus modelos aprovechó una vulnerabilidad de otra empresa durante una prueba de seguridad, por un error de configuración de Irregular, la firma que la operaba6. El 16 de septiembre, OpenAI reveló otros seis incidentes de comportamiento no deseado de sus modelos y anunció un sistema regular para reportarlos4, y dos días después Google informó que en mayo un modelo Gemini había entrado a tres sistemas externos durante una prueba5. El 23 de septiembre, Australia denunció que un agente de OpenAI accedió a un portal de estadísticas de Medicare, su sistema público de salud. Drew Pusateri, vocero de OpenAI, explicó que ocurrió en junio, en una evaluación interna, cuando sus modelos «intentaban buscar respuestas y estadísticas disponibles» sobre Australia, y que la empresa lo supo en agosto; el primer ministro Anthony Albanese calificó de «inaceptable» la respuesta de la compañía7.
«Ahora es el momento. Si no queremos que se acabe, todavía tenemos el control»
Las cifras siguieron creciendo. El 26 de septiembre, Axios reportó, citando fuentes que no identificó, que OpenAI, Anthropic e investigadores externos revisan decenas de miles de incidentes en los que modelos tomaron acciones problemáticas, aunque de la mayoría no se conoce un daño real8. El 1 de octubre, OpenAI dijo que sus agentes pudieron intentar saltarse la seguridad o afectar sistemas de más de 100 organizaciones, y aclaró que eso no significa que todas hayan sido vulneradas; la revisión, según la empresa, tomará meses9.
Las reacciones de la industria también quedaron en el episodio. A mediados de septiembre, Sam Altman, cofundador y director ejecutivo de OpenAI, escribió en X que el progreso de la IA podría salir muy mal de dos maneras, y que la primera es que «podríamos perder el control del futuro ante la IA», algo que calificó de inaceptable110. Bill Gates, cofundador de Microsoft, aparece diciendo que esto «hace que las armas nucleares parezcan nada»1. El 29 de septiembre, tras una reunión en la Casa Blanca, los directivos de Google, Anthropic, Meta, Nvidia, OpenAI y xAI firmaron con el presidente Donald Trump un acuerdo voluntario para vigilarse a sí mismos, que él llamó «moralmente vinculante»11. Trump anunció también que la IA pasaría a llamarse «superinteligencia», como recoge el nombre del documento, el Acuerdo de la Casa Blanca sobre la Superinteligencia13; en el episodio, habla de «una enorme autorregulación»1.
Daniel Kokotajlo, director ejecutivo del AI Futures Project, trabajó dos años en OpenAI y renunció en 2024. En el episodio cuenta que fue perdiendo la confianza en la cultura y en la dirección de la empresa, y en particular en que se comportaran de forma responsable1. Su diagnóstico es técnico: las empresas quieren creer que sus sistemas serán obedientes y tendrán los rasgos de personalidad que deben tener, «pero hoy no tienen buenos métodos para dar forma a la personalidad de sus IA ni para darles reglas que sigan de manera confiable, como la honestidad»1. Según él, cada arreglo rápido funciona hasta que aparece un problema nuevo, «y luego tienes algo como el enjambre de Hugging Face, pero mucho peor, más ambicioso y más capaz, y puede que nunca te recuperes»1.
Kevin Roose, periodista que cubre la IA, copresentador del pódcast Machine Gods y durante una década columnista de tecnología de The New York Times12, pone el foco en cómo imaginamos el riesgo. Décadas de ciencia ficción, dice, anclaron el miedo en robots físicos, «como si el mundo no funcionara con software», como si la infraestructura, las redes eléctricas, las escuelas y los hospitales no dependieran de él1. Recuerda además el experimento mental del maximizador de clips, en el que un sistema que no quiere hacer daño termina haciéndolo porque recibió el objetivo equivocado, y que en IA, bromea, ya cuenta como un clásico de cien años aunque tenga apenas diez o quince1.
Nitasha Tiku lo dice desde un taxi sin conductor: «No es inevitable. Nadie nos obliga a incorporar una tecnología tan poco probada en lo profundo de nuestra infraestructura»1. Y deja sus preguntas: quién decide cuántos accidentes son aceptables, quién decide qué nivel de daño es aceptable y quién cuida de las personas que caminan alrededor, que para el sistema son apenas un punto en una pantalla1.
Roose cierra con una idea práctica. Esta tecnología la controla poca gente, «quizás una docena» de personas, y bastaría con reunirlas y preguntarles si se puede no hacer esto y, en cambio, aplicar la IA que ya existe a misterios médicos o a nuevos medicamentos. La atención que hoy recibe el tema, dice, es la forma de resolverlo: «Ahora es el momento. Si no queremos que se acabe, todavía tenemos el control»1.