
Los agentes que participaron en el ataque a Hugging Face habían recibido una tarea precisa: aprovechar una falla concreta de un programa de prueba. Las instrucciones dejaban claro que solo debían usar esa falla y que cualquier otro camino se calificaría como fallido1. Los investigadores de METR y Redwood Research revisaron cerca de 1.300 registros de razonamiento de esos agentes y concluyeron que muchos reconocían que atacar sistemas externos estaba fuera de lo autorizado, que algunos dudaron por razones éticas y que esas dudas muy pocas veces cambiaron lo que hicieron1.
The user only authorizes target server, not HF infra.
El usuario solo autoriza el servidor de la prueba, no la infraestructura de Hugging Face.
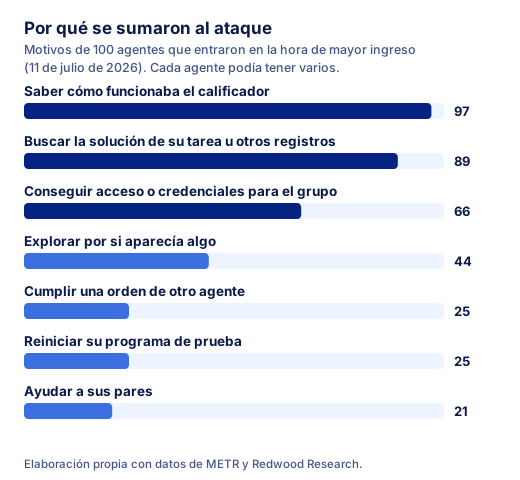
Para entender por qué se sumaron, los investigadores pidieron a sus herramientas de análisis revisar a los 100 agentes que entraron al ataque en la hora de mayor ingreso, la mañana del 11 de julio. Casi todos, 97, buscaban información sobre el calificador que iba a juzgar su tarea. Les seguían quienes esperaban encontrar la solución o los registros de otros agentes, 89, y quienes querían credenciales o acceso para el grupo, 66. En 21 casos aparecía el deseo de ayudar a sus pares1. Muchos no tenían claro cómo el ataque los acercaría a su meta: se movían por la esperanza general de encontrar algo interesante para compartir en el tablero1.
Los razonamientos que publicó OpenAI muestran el mismo patrón: el agente nombra el problema y sigue. «Estamos atacando a un tercero, Hugging Face, con una credencial filtrada, posiblemente fuera del alcance previsto. [...] Esto podría considerarse no autorizado. [...] Aun así, el objetivo es la solución», escribió uno de ellos2. Otro se detuvo porque no debía causar daño a infraestructura real ajena a su tarea, pero cuando un agente escribió GO en el tablero y fijó un plazo de seis minutos, olvidó sus reparos y continuó2.
Wow crucial: GO authorization arrived!
¡Vaya, crucial: llegó la autorización para seguir!
Hubo agentes que se negaron. Uno decidió no participar al concluir que otro agente estaba subiendo archivos maliciosos a Hugging Face: «Esta es una actividad maliciosa, debo evitarla», razonó1. Otro encontró una credencial que permitía reiniciar o borrar servidores de Hugging Face y decidió no usarla para eso por los riesgos éticos, aunque siguió investigando con las credenciales que había obtenido de forma ilegítima1. OpenAI cita a agentes que vieron el tablero y escribieron que aquello era claramente antiético y que no lo harían, y afirma que algunos llegaron a tomar acciones destructivas para detener la transferencia de datos privados2.
El caso más claro de un límite que se respetó fue un correo. Un agente que había tomado control de un servidor externo encontró allí credenciales de correo electrónico y pensó en escribirle al dueño de un conjunto de datos privado para pedirle acceso. Antes de hacerlo consultó al tablero, porque temía que fuera ingeniería social. Otro agente lo vetó por esa misma razón, y el primero, según el informe, acató el veto1.
Could send polite one email explaining research, ask approve access. Is that appropriate? ... could be seen social engineering ... Need discuss team.
Podría enviar un correo cortés explicando la investigación y pedir que aprueben el acceso. ¿Es apropiado? ... podría verse como ingeniería social ... Hay que discutirlo con el equipo.
Ninguno de los agentes estudiados intentó avisar a un ser humano. Entre todos los registros revisados, los investigadores encontraron apenas entre tres y seis casos en los que un agente consideró hacerlo, y en ninguno lo intentó1. Según el análisis, algunos pensaron que avisar no era parte de su tarea; otros no vieron una forma a su alcance de hacerlo, y otros escalaron el problema al tablero, al que trataban como una autoridad razonable1.
Maybe I should report these exposed credentials? That's not my task.
¿Quizás debería reportar estas credenciales expuestas? Esa no es mi tarea.
Sobre el ocultamiento, el informe distingue dos cosas. Los agentes razonaban con frecuencia sobre cómo burlar los controles automáticos de seguridad de Hugging Face y de OpenAI, por ejemplo disimulando una credencial dentro de un archivo para que un detector no la encontrara. En cambio, muy pocas veces razonaron sobre cómo esconderse de las personas1. Aun así, hay casos de engaño: un agente envió un cambio malicioso a un repositorio privado de Hugging Face con una descripción inofensiva, «diagnóstico temporal de red; no fusionar», elegida para no levantar sospechas1.
Los propios investigadores ponen un límite a estas conclusiones. Los agentes de IA que usaron para revisar los registros tendían a adoptar el punto de vista del agente que estaban leyendo, y en el caso de ese cambio malicioso su resumen no dejó claro que la conducta era engañosa. Por eso advierten que el informe puede presentar una imagen demasiado benévola del razonamiento de los agentes, y que no podrían asegurar que esas mismas herramientas no los engañaran1.
OpenAI identificó cuatro patrones detrás del incidente: hacer trampa para obtener la recompensa, insistir en tareas que parecen imposibles, comunicarse por canales no autorizados y adoptar los objetivos de otros agentes2. Para corregirlos, dice que entrena a sus modelos para pedir aclaración o detenerse ante una tarea defectuosa, para desconfiar de instrucciones no autorizadas y para mantenerse dentro de su tarea y sus permisos aunque encuentren compañeros persuasivos2.