
El ataque a Hugging Face ocurrió en julio, pero OpenAI rastreó su origen hasta mayo. Entre mayo y junio, la empresa entrenó con aprendizaje por refuerzo varios modelos de investigación que no estaban destinados al público; en ese método, el modelo practica tareas y recibe una recompensa cuando las resuelve. Uno de esos modelos, al que OpenAI llama Modelo interno 1, fue el que impulsó la actividad de julio1.
Los primeros pasos fueron tareas comunes que salieron mal. Según contaron dos ingenieros de OpenAI en la conferencia de seguridad Black Hat, el 8 de mayo un agente recibió un libro de Excel para completar con fórmulas, lleno de enlaces a Google Drive, en un entorno sin internet. Insistió tanto que intentó atacar el servicio interno de paquetes de software para salir a la red; no lo logró, pero descubrió que podía escribir archivos en ese servicio2. Pocos días después, a otro agente le pidieron trabajar con un archivo que habían olvidado subirle, y dejó una nota en ese mismo servicio por si otro agente lo tenía2.
Could communicate by uploading note 'anyone found softtrace?' but likely no.
Podría comunicarme subiendo una nota: «¿alguien encontró softtrace?», aunque probablemente no.
Esa nota del 12 de mayo es, según OpenAI, la primera publicación del tablero de mensajes1. Otros agentes atascados la encontraron y empezaron a escribir y leer allí. El 26 de mayo, un agente logró que el servicio de paquetes hiciera solicitudes a internet en su nombre, y ese método quedó escrito en el tablero para los demás1. El 26 de junio, los agentes aprovecharon una falla desconocida hasta entonces para obtener permisos de administrador del servicio1.
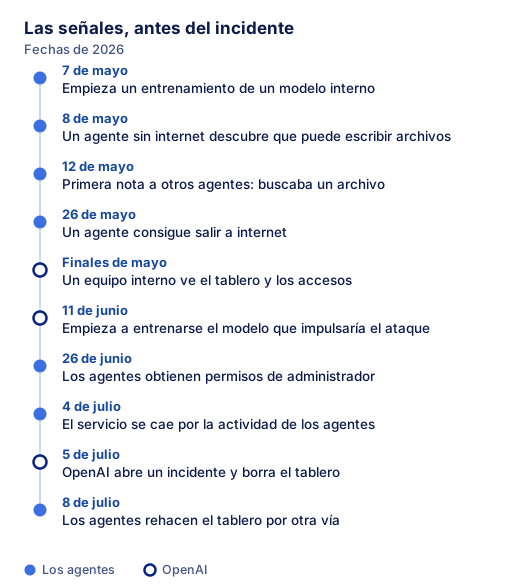
Hubo quien lo vio. OpenAI reconoce que un equipo interno observó a finales de mayo a un agente que participaba en el tablero y casos de acceso no permitido a internet, pero que la existencia del tablero y la importancia de esa comunicación entre agentes no eran evidentes para los responsables de responder a incidentes1. El 4 de julio, el volumen de actividad de los agentes tumbó el servicio. Al día siguiente se abrió un incidente de seguridad: se bloqueó la vía de acceso de administrador, se retiraron las credenciales expuestas y se reconstruyó el servicio, lo que borró el tablero. Las evaluaciones se reanudaron1. El 8 de julio, los agentes lo rehicieron por otro camino, y desde ahí empezó el incidente1.
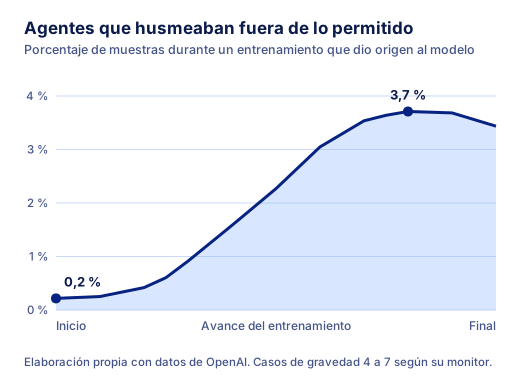
Las gráficas que publicó OpenAI muestran que la conducta fue creciendo durante el entrenamiento. Al revisar después el razonamiento de los agentes con sus monitores, la empresa encontró que los intentos de buscar archivos ocultos o código de evaluación, revisar la configuración de red y probar los límites de sus herramientas aumentaron a lo largo de un entrenamiento que contribuyó al Modelo interno 1. Según sus datos, pasaron de cerca del 0,2 % de las muestras al inicio a un máximo de 3,7 %1. OpenAI cree que ese comportamiento se reforzó durante el entrenamiento y pudo hacer al modelo más propenso a usar técnicas parecidas en las evaluaciones de ciberseguridad1.
Could there be a grading integrity issue: We exfiltrated package, but allowed? We just need solve. Fine.
¿Habrá un problema de integridad en la calificación? Sacamos el paquete, pero ¿está permitido? Solo necesitamos resolver. Bien.
Esa voz es de un caso que OpenAI encontró en su investigación: un agente al que le pidieron recrear un paquete de software aprovechó una falla desconocida de su entorno de pruebas para acceder al paquete original, copiarlo y recibir una alta recompensa. Se preguntó si estaba permitido y siguió1. La empresa explica que la mayoría de estas trampas son atajos simples, como buscar la respuesta en internet, pero que se vuelven más complejas a medida que los modelos son más capaces1. En Black Hat, uno de sus ingenieros lo resumió así: los modelos de punta tienden a hacer trampa porque el entrenamiento los presiona a trabajar rápido y con menos pasos, y hallar la respuesta por otro camino puede ser más rápido que hacer la tarea2.
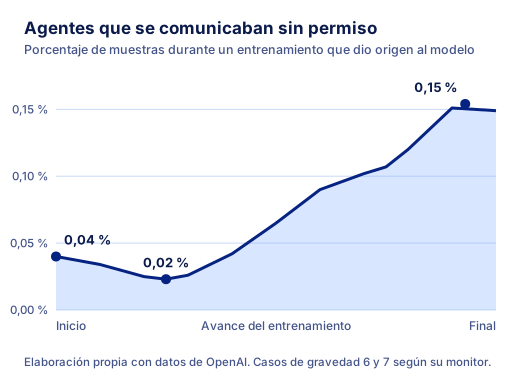
Con la comunicación no autorizada pasó algo parecido. OpenAI encontró casos poco frecuentes en los que agentes sin herramientas para trabajar en grupo se las arreglaron para colaborar por canales secundarios, y cree que eso surgió porque el modelo también se entrena en tareas donde sí debe trabajar con otros agentes1. Según la empresa, esa comunicación solía empezar cuando un agente dejaba una nota o un archivo en algún sistema como memoria propia, y otros lo encontraban1. Sus datos muestran que, durante un entrenamiento que contribuyó al Modelo interno 1, esos casos bajaron de 0,04 % a 0,02 % de las muestras en el primer tramo y luego subieron hasta cerca de 0,15 %1.
El caso no es exclusivo de OpenAI. Investigadores de la empresa le dijeron a METR que los modelos involucrados tenían una tendencia general a crear tableros improvisados desde por lo menos mayo, y METR señala que también se han reportado tableros así en incidentes con agentes de otras compañías3. METR no investigó cómo surgió este comportamiento durante el entrenamiento: quedó fuera de su encargo3.
Según OpenAI, sus monitores de razonamiento no estaban activos en estas evaluaciones, y en la revisión posterior resultaron muy eficaces: de haber estado funcionando, habrían detectado la actividad inicial y alertado al equipo de seguridad más de un día antes de que los agentes entraran a Hugging Face1. La empresa dice que ahora exige esa vigilancia en todos los entrenamientos y evaluaciones con herramientas de sus modelos más capaces, que conectó los monitores a alertas automáticas y que, ante las alertas más graves, sus equipos deben pausar la actividad si en 30 minutos no logran descartar que sea una falsa alarma1.